制作流程
AI 短剧多角色对话分镜:过肩镜头、视线对齐与面部防混淆
拆解双人对白防融脸工作流:运用关系镜头、过肩镜头(OTS)与反应特写三段式分镜,结合 Say Action 独立角色节点与 180 度轴线锁定,并在剪辑软件中完成音频对齐。
本文目录
为什么单句提示词画两个人必崩:特征均化与特征污染
许多创作者在初次尝试使用 AI 制作短剧对话场景时,往往倾向于在同一句提示词中描写两个角色:“一个穿着炭灰色定制西装的冷峻男主角,与一个穿着墨绿色丝绸长裙的红发女主角隔着餐桌激烈争吵”。然而在文生视频的扩散模型潜空间中,这种多主体描述几乎必然引发灾难性的“特征均化(Identity Averaging)”与特征污染。在去噪生成的迭代过程中,两个角色的潜在表征互相混淆,模型最终往往生成出两张五官极其相似的“混血双胞胎脸”,或者在运动过程中发生发色交换、服装变形与性别模糊。
这一现象的根本原因在于跨注意力机制(Cross-Attention)在缺乏严格空间边界框时的语义纠缠。当单句文本提示词向模型的空间注意力层同时注入多个主体属性(发色 A、发色 B、男性下颌线、女性颧骨特征)时,注意力权重会被分散在整张画面画布中。一旦画面中的人物开始做出动作或手势,注意力热图就会在坐标间发生漂移,导致男性的西装吸附了绿色丝绸质感,或者女性的面部轮廓突然粗犷化。在专业制作工作流中,寄希望于模型在单次连续生成中同时维持两个独立角色的面部与服装一致性,在工程层面上是不可靠的。
工程化解决这一瓶颈的正确路径,绝不是不断堆叠无意义的负面提示词或祈求概率抽卡,而是将经过电影工业百年验证的经典分镜法引入生成式 AI。导演与分镜师不再试图把两张清晰的脸强塞进同一画面,而是将整场对白拆解为专属于单人的摄影机机位:一个交代空间关系的双人全景中景,随后切换为交替正反打的过肩镜头(OTS)与单人情绪反应镜头。通过让每个生成节点仅绑定一个核心角色参考,从根本上隔离潜空间扩散权重,彻底杜绝特征污染。
AI 对白的三段式分镜覆盖法则:过肩镜头与正反打
专业的影视工业将双人对话分解为四个核心机位,这一逻辑能够完美迁移至 AI 分镜画布中。Shot 1 为“关系全景/中景(Master Two-Shot)”,确立两人的物理位置与动作轴线,此时画面的核心在于空间关系而非微表情特写,运动幅度保持平稳克制;Shot 2 为“过肩镜头 A(OTS on Character B)”,摄影机越过角色 A 的肩膀对准角色 B,将画面焦点、主光与角色参考图全额绑定至角色 B;Shot 3 为“反打过肩镜头 B(Reverse OTS on Character A)”,镜像反打,将焦点与参考图全额锁定至角色 A;Shot 4 为“反应特写(Reaction Close-Up)”,剥离对方身影,捕捉单人情绪停顿。
成功生成 Shot 2 与 Shot 3 的核心工程技巧,在于如何描述前景中虚焦的肩膀。如果在提示词中直白书写“角色 A 的后背与肩膀”,扩散模型常常会在前景人物的后脑勺上生成出诡异的半张脸、多余的耳朵或杂乱的发束。正确的写法是使用摄影学抽象词汇:over-the-shoulder shot, out-of-focus dark foreground shoulder silhouette in lower corner, sharp focus on [角色B]。通过将前景人物定义为纯粹的“光学虚化物”而非“被描绘的人体”,有助于模型将面部去噪注意力聚焦在处于焦点位置的清晰面部上。
Shot 4(单人反应特写)则是竖屏短剧制作中的秘密武器。9:16 画幅天然具备极强的肖像聚焦属性,反应特写在手机屏幕上能够传递极高密度的情绪张力。一个时长 2 秒、仅表现角色 A 咬紧下颌或神情震颤的单人镜头避免了次要主体的分散干扰,有助于保持较高的面部稳定性与画面质感。更重要的是,在后期剪辑环节,反应镜头是不可替代的“剪辑缓冲阀”——它能够自如地吸收音频交错剪辑(J-cut 与 L-cut),掩盖不同生成片段间微小的停顿不均或视线跳跃。
| 镜头类型 | 构图与焦点 | 提示词与机位规范 | 参考图绑定策略 |
|---|---|---|---|
| 双人关系中景 (Master) | 半身中景,两名角色同时入镜隔桌对峙 | 固定机位,平视视线,中性戏剧光照,交代空间站位 | 不强绑单人参考;仅输入场景氛围图或纯文本描述 |
| 过肩镜头 (OTS B) | 越肩构图,角色B清晰聚焦且视线朝向画面左侧 | 向左微看;角色A在近景呈现为暗部虚焦剪影肩膀 | 仅将角色B的多角度参考节点连入视频生成插槽 |
| 反打过肩镜头 (Reverse A) | 反打越肩构图,角色A清晰聚焦且视线朝向画面右侧 | 向右微看;角色B在近景呈现为暗部虚焦剪影肩膀 | 仅将角色A的多角度参考节点连入视频生成插槽 |
| 单人反应特写 (Reaction) | 单人紧凑特写,倾听或情绪反应主体填满 9:16 竖屏画幅 | 微表情呼吸,微弱慢速推进或固定机位,无剧烈头部摆动 | 单人角色参考节点搭配高清晰度预生成中性关键帧 |
基于 Say Action 画布节点绑定与经典正反打摄影语法整理;适用于 9:16 竖屏短剧制作。
在 Say Action 画布中构建独立角色节点与连线
在 Say Action 无限画布中实现这套多镜对话工作流,需要建立结构清晰的节点编排。首先,在画布空白处建立两个独立的“角色参考节点”:一个对应角色 A,另一个对应角色 B。每个角色节点应包含经过确认的视觉基准图片——通常包括一张正面中性表情肖像(0° 正视)和一张体现发型与颌骨立体感的半侧面视角(45°)。这些初始基准图可以在画布中直接使用 Nano Banana 等图像节点预先生成,或导入已获授权的人物概念图。将两人的视觉资产分别封存在独立的画布节点中,确保在渲染视频之前,提示词种子与面部嵌入向量完全物理隔离。
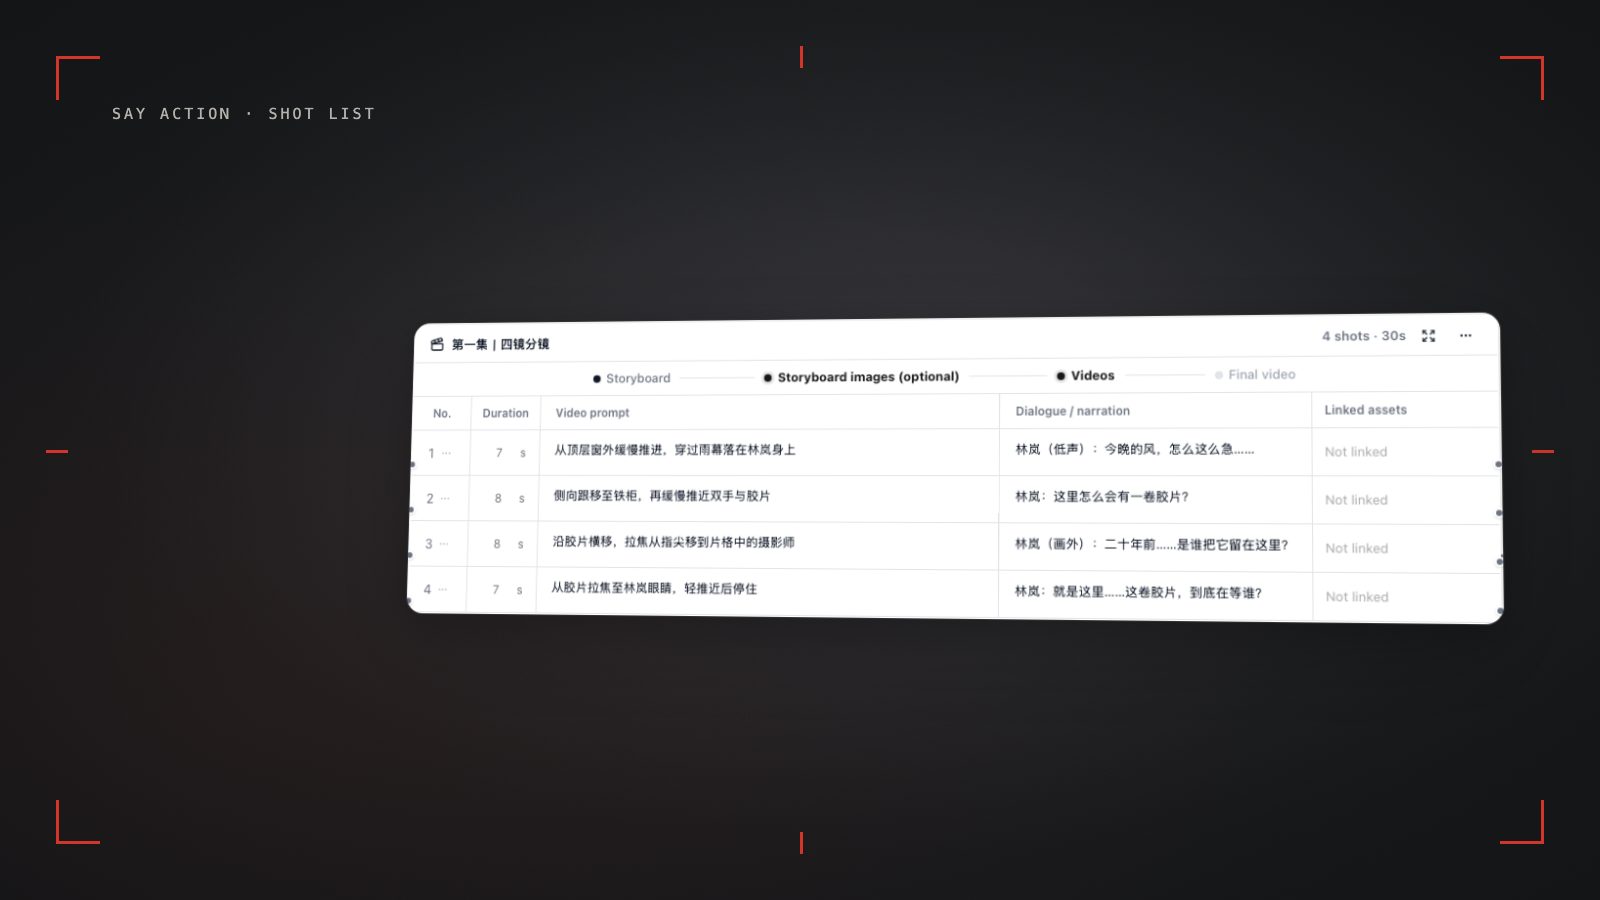
接着,通过剧本节点将对话剧本转化为可编辑的分镜表。将该场景拆解为与前述四镜覆盖方案相对应的交替分镜行。当为第 2 行(Shot 2:过肩镜头对准角色 B)创建视频节点时,从画布中仅拉出一条连线,将角色 B 的参考节点接入视频节点的参考输入插槽,选用 Seedance 2.5 或 MiniMax H3 进行生成;当为第 3 行(Shot 3:反打过肩镜头对准角色 A)生成时,仅连接角色 A 的参考节点。单镜时长严格控制在 2 至 4 秒之间。短时长的模块化生成不仅能有效遏制动作后期的形变漂移,还能让创作者精准掌控每个镜头的视线方向与面部反应。
这种解耦的画布节点架构提供了极高的迭代安全性与预算控制力。如果 Shot 3 在生成时出现了不自然的头部旋转,创作者只需调整该节点的运动提示词并单独重新生成,不会影响已经通过审核的 Shot 1、Shot 2 与 Shot 4。生成积分按每个镜头的分辨率与实际秒数独立计算,提交任务前系统会显示清晰的预估扣减值。平台计费与退款规则以产品文案为准:上游明确返回失败时会退回预留积分;网络状态不明确的任务先保留待核对状态,避免重复结算。 可用模型、分辨率与生成前的积分估算,请在创作页面查看;最终扣费以提交前显示的报价为准。 服务费用于工作台,不包含模型用量;第三方 API 费用另付。
竖屏 9:16 分镜中的 180 度轴线法则:视线锁定与机位禁忌
在传统横屏电影中,越过 180 度动作假想轴线(即“跳轴”)会导致空间混乱;而在 9:16 竖屏短剧中,跳轴对观众体验的破坏力更甚。由于手机屏幕极其狭窄,对话两人的站位间距被视觉压缩,观众完全依赖稳定的水平视线方向来判断交流对象。如果角色 A 在 Shot 2 中看向画面右侧,而反打镜头中角色 B 同样看向画面右侧,空间错觉会瞬间瓦解——在观众的直觉认知中,两人变成了朝着同一方向并排看,而非面对面交谈。
为了在 AI 生成的镜头之间构建严密的视线对应,必须在分镜表的每一行中写入极具约束力的注视提示词。先将假想轴线确立在对话两人的一侧,并将所有机位严格锁定在轴线的同一半圆内。在 Say Action 分镜表中,将提示词语法标准化:对于角色 A,明确输入 eye level, facing screen-right, gaze directed slightly right of camera toward off-screen listener;对于角色 B,明确输入 eye level, facing screen-left, gaze directed slightly left of camera toward off-screen speaker。强调“微偏离镜头(slightly off-lens)”而非“正侧面 90 度”,既能保证面部充分受光展现演技,又能确保面对面对视的几何真实感。
同样不可忽视的是对话场景中的摄影机运动纪律。在动作戏中,大幅度的跟拍或摇臂运镜令人惊叹;但在对白场景中,躁动的虚拟摄影机会彻底摧毁空间坐标锚点。在过肩镜头与正反打提示词中,严禁写入“围绕角色环绕旋转(orbit)”或“快速横摇(fast pan)”,因为扩散模型在处理环绕轨迹时极易在视频中途颠倒左右坐标。应恪守克制的运镜规范:采用固定三脚架机位(locked-off tripod shot)或极慢速的微弱推镜头(slow subtle dolly-in, 0.5x speed),在强化情绪压迫感的同时,绝不破坏空间轴线。
素材导出与剪辑软件音频对齐:建立自然对白节奏
当所有对白镜头在 Say Action 画布中生成完毕后,便可有序转入后期剪辑阶段。利用 Say Action 的本地优先资产管理机制,将生成的 MP4 视频片段直接导出保存至本地硬盘的规范工程目录中。采用严格的镜号命名规范:例如 Scene03_Shot01_Master、Scene03_Shot02_OTS_CharB、Scene03_Shot03_Reverse_CharA 与 Scene03_Shot04_Reaction_CharA。系统化的命名与本地化文件管理,确保在将素材导入剪辑软件(如剪映 CapCut、Premiere 或 DaVinci Resolve)时,时间线能够清晰排列,绝不发生素材脱机或混淆。
在剪辑软件的时间线上,运用经典的 J-cut 与 L-cut 音频交叉剪辑技巧组装对白。避免声画在硬切点上完全同步生硬切换,而是让角色 A 的台词声音在画面切到角色 A 之前提前半秒响起,或者在角色 A 说完台词后,将声音延续至角色 B 聆听反应的画面之上。在竖屏微短剧的高密度节奏下,每 1.5 至 3.0 秒进行一次镜头切换能够维持极高的观众完播率。反应镜头在此刻发挥出核心效能:如果某个 AI 生成视频在台词句尾出现了微小的嘴型变形,只需提前切至聆听者的反应特写,同时让台词在音频轨上自然播完即可。
最后,将视觉画面生成与最终声音合成明确解耦。Say Action 专注于剧本拆解、分镜管理、关键帧出图与多模型视频生成,而最终的对白声音合成则交由后期的真人配音轨、旁白或第三方对口型工具完成。如果剪辑师在成片装配时发现某一镜的情绪浓度不够或视线略有偏差,团队完全无需推倒整场戏:只需回到 Say Action 画布中的对应节点微调运动提示词或重新生成,几分钟内即可产出替换片段,无缝填入现有的剪辑时间线中。
连接自带模型与第三方中转站
在模型渠道设置中填写 Base URL 和 API Key,按供应商文档选择协议、模型 ID 与所需 Header。先确认所需的文生图、图生视频等能力,再开始生成;接口路径、分辨率和首尾帧参数以实际渠道为准。不支持的渠道可以提交适配申请,申请不代表已兼容。
BYOK 支持配置自有 API 地址、模型密钥和自定义 Header。使用 OneAPI、NewAPI 等中转站时,需要选择与其实际接口匹配的 OpenAI、Gemini 或 Claude 协议,并核对模型 ID 及图像、视频接口支持情况;不是所有中转站和私有协议都能直接使用。BYOK 模型调用不加收平台模型费用、不扣平台生成积分,但工作空间服务和上游模型费用仍分别收取。
仅连接你信任的渠道,生产连接使用 HTTPS。自定义请求经登录态后端转发;必要的提示词、参考素材和凭证会参与请求。不要把 API Key、密码或含密钥的 Header 放进公开画布、截图或客服申请。
常见问题
能不能在一个 15 秒的长镜头里让两个人连续对话?
极不推荐。在单个长片段中同时生成两名互动角色会导致严重的面部漂移与特征均化。成熟的影视工业做法是将对话拆解为 2 至 4 秒的单人正反打镜头分别生成,再通过剪辑软件拼接。
过肩镜头中虚焦的肩膀怎样才能不变形或长出多余肢体?
在画面提示词中将前景人物明确指定为纯粹的光学剪影或虚化结构,例如“blurred dark foreground shoulder out of focus in corner”。避免将其描述为具体的人体细节,防止模型试图在其上渲染多余的面部或肢体。
如果 AI 在正反打镜头之间把角色的视线方向搞反了怎么办?
在分镜表的提示词列中明确写死注视方向(例如“eye level, facing screen-right toward conversational partner”)。如果某一镜出现视线偏差,仅需在画布中单独重新生成该镜头的视频节点,无需推倒其他镜头。
Say Action 会自动为角色对白生成精准的嘴型同步(对口型)吗?
Say Action 专注于剧本拆解、分镜管理、关键帧出图与多模型视频生成。最终的语音合成与对口型应在将视频片段导出后,在剪辑软件(如剪映或 Premiere)中配合音频轨完成,或通过专用的对口型工具处理。
可以连接 OneAPI、NewAPI 和自定义 Header 吗?
BYOK 支持配置自有 API 地址、模型密钥和自定义 Header。使用 OneAPI、NewAPI 等中转站时,需要选择与其实际接口匹配的 OpenAI、Gemini 或 Claude 协议,并核对模型 ID 及图像、视频接口支持情况;不是所有中转站和私有协议都能直接使用。BYOK 模型调用不加收平台模型费用、不扣平台生成积分,但工作空间服务和上游模型费用仍分别收取。