제작 워크플로우
AI 숏폼 드라마 다중 인물 대화 연출법: OTS 샷, 시선 일치 및 얼굴 뒤섞임 방지 워크플로우
AI 영상 대화 씬의 얼굴 뒤섞임(Identity Averaging)을 해결하는 정통 연출법: 마스터 샷, 오버 더 숄더(OTS), 단독 리액션 3단계 분할과 캔버스 독립 노드 연결, 180도 가상선 시선 고정.
목차
한 프롬프트에 두 인물을 함께 넣으면 실패하는 이유: 아이덴티티 블렌딩 현상
생성형 AI 비디오로 인물 간 대화 씬을 처음 제작하는 창작자들은 흔히 하나의 프롬프트에 두 인물을 동시에 묘사하곤 합니다. "차콜 수트를 입은 남성과 에메랄드 실크 드레스를 입은 붉은 머리 여성이 식탁을 사이에 두고 격렬하게 언쟁하는 장면"과 같은 프롬프트는 확산 모델의 잠재 공간(Latent Space)에서 필연적으로 '아이덴티티 블렌딩(Identity Averaging)'과 특성 교차 오염을 일으킵니다. 디노이징 과정에서 두 인물의 시각적 표현이 뒤섞여 동일한 이목구비를 지닌 쌍둥이처럼 합성되거나, 영상 재생 중 머리 색과 의상, 성별적 특성이 서로 바뀌며 변형되는 문제가 발생합니다.
이러한 현상의 기술적 근본 원인은 명확한 공간적 경계(Bounding Box) 없이 작동하는 크로스 어텐션(Cross-Attention) 메커니즘의 특성에 있습니다. 단일 텍스트 프롬프트에 여러 인물의 속성(헤어스타일 A, 헤어스타일 B, 남성적 턱선, 여성적 얼굴 윤곽)이 공존할 때, 공간 어텐션 레이어는 해당 가중치를 화면 전체에 분산 배치합니다. 인물이 움직이거나 손짓을 시작하면 어텐션 영역이 프레임 내에서 뒤흔들리며, 남성의 정장에 초록색 실크 질감이 번지거나 여성의 얼굴에 남성적 골격이 합성됩니다. 상용 제작 파이프라인에서 단 한 번의 연속 생성으로 두 인물의 독립적인 외형 일관성을 동시에 유지하려는 시도는 기술적으로 안정적이지 못합니다.
이 병목을 실무에서 해결하는 올바른 접근법은 의미 없는 부정 프롬프트를 나열하거나 확률에 기대어 무한 재생성을 돌리는 것이 아닙니다. 영화 제작에서 오랜 시간 검증된 정통 카메라 커버리지 기법을 생성형 AI 파이프라인에 이식해야 합니다. 하나의 프레임에 두 얼굴을 동시에 담으려 고집하지 않고, 공간 관계를 설명하는 마스터 샷을 먼저 확립한 뒤 오버 더 숄더(OTS) 쇼트와 단독 리액션 컷으로 대화를 분해하는 것입니다. 각 영상 생성 노드마다 오직 한 명의 핵심 캐릭터 참조만 연결함으로써 잠재 공간의 특성 간섭을 원천 차단합니다.
AI 대화 씬 3단계 커버리지 법칙: OTS 샷과 쇼트-리버스-쇼트
전문 영상 제작의 대화 씬 연출은 AI 콘티 캔버스에 최적화된 4가지 핵심 카메라 셋업으로 분해됩니다. 컷 1은 공간적 관계를 확립하는 '마스터 투샷(Master Two-Shot)'으로, 두 인물의 물리적 거리와 시선 축을 확정합니다. 이 컷에서는 과도한 얼굴 디테일보다 인물의 공간 배치가 우선입니다. 컷 2는 인물 A의 어깨 너머로 인물 B를 바라보는 '오버 더 숄더 샷(OTS)'이며, 초점과 레퍼런스 바인딩을 온전히 인물 B에게만 부여합니다. 컷 3은 반대편에서 인물 A를 포착하는 '리버스 OTS 샷'으로 인물 A를 전담합니다. 컷 4는 감정적 호흡을 극대화하는 '단독 리액션 클로즈업'입니다.
컷 2와 컷 3 생성을 성공으로 이끄는 결정적 테크닉은 전경에 위치한 아웃포커싱 어깨를 프롬프트로 처리하는 방식에 있습니다. 프롬프트에 "인물 A의 등과 어깨"라고 서술하면, 확산 모델은 전경 인물의 뒤통수에도 얼굴 파편이나 불필요한 귀를 생성하려는 오류를 범합니다. 이를 원천 차단하기 위해 over-the-shoulder shot, out-of-focus dark foreground shoulder silhouette in lower corner, sharp focus on [인물 B]와 같이 광학적 요소로 추상화해야 합니다. 전경의 신체를 렌즈 앞을 가리는 어두운 실루엣으로 정의함으로써, 모델이 시선이 닿는 선명한 얼굴에 디노이징 어텐션을 집중하도록 돕습니다.
컷 4(단독 리액션 클로즈업)는 숏폼 모바일 드라마에서 가장 위력적인 연출 카드입니다. 9:16 세로형 프레임은 인물 집중도가 매우 높기 때문에, 단독 클로즈업은 스마트폰 화면에서 압도적인 감정적 몰입을 만들어냅니다. 상대방의 말에 턱을 굳히거나 숨을 들이켜는 2초 길이의 리액션 컷은 화면 내 경쟁 주체가 없어 얼굴 일관성이 가장 안정적으로 유지됩니다. 또한 외부 편집기로 넘어갔을 때 리액션 컷은 오디오의 J컷 및 L컷 편집을 자연스럽게 덮어주고, 컷 간의 미세한 시각적 불연속성을 완벽히 흡수하는 안전판 역할을 합니다.
| 샷 유형 | 구도 및 초점 | 프롬프트 및 카메라 지침 | 참조 이미지 바인딩 |
|---|---|---|---|
| 마스터 투샷 (Master) | 바스트/웨이스트 중경, 두 인물이 테이블을 두고 마주 선 구도 | 고정 카메라, 눈높이 앵글, 중립 조명, 대화 공간의 물리적 축 확립 | 특정 인물 단독 참조를 묶지 않고 씬 무드보드 또는 텍스트만 전달 |
| 오버 더 숄더 샷 (OTS B) | 어깨 너머 구도, 인물 B에게 선명한 초점 및 화면 좌측 응시 | 카메라 살짝 좌측 응시; 전경의 인물 A는 어둡고 흐린 실루엣 어깨로 처리 | 인물 B의 다각도 캐릭터 참조 노드만 비디오 입력 슬롯에 연결 |
| 리버스 OTS 샷 (Reverse A) | 반대편 어깨 너머 구도, 인물 A에게 선명한 초점 및 화면 우측 응시 | 카메라 살짝 우측 응시; 전경의 인물 B는 어둡고 흐린 실루엣 어깨로 처리 | 인물 A의 다각도 캐릭터 참조 노드만 비디오 입력 슬롯에 연결 |
| 단독 리액션 클로즈업 | 타이트한 단독 클로즈업, 반응하는 인물의 얼굴이 9:16 프레임을 채움 | 미세한 표정 호흡, 미세한 슬로우 돌리인 또는 완벽한 고정 샷 | 단일 인물 참조 노드와 사전 생성한 고해상도 키프레임 결합 |
Say Action 캔버스 노드 바인딩과 고전적인 쇼트-리버스-쇼트 연출법에 기반한 구성; 9:16 세로형 영상 적용 기준.
Say Action 캔버스에서 개별 인물 노드 구축 및 연결하기
Say Action 무한 캔버스에서 이 대화 분할 워크플로우를 구현하려면 체계적인 노드 구조화가 선행되어야 합니다. 먼저 캔버스 공간에 인물 A와 인물 B를 위한 독립적인 '캐릭터 참조 노드' 2개를 각각 생성합니다. 각 인물 노드에는 정면 0도 무표정 샷과 헤어스타일 및 턱선 입체감을 보여주는 45도 반측면 샷 등 검증된 기준 이미지를 배치합니다. 이 기준 키프레임은 캔버스 내 이미지 생성 노드(Nano Banana 등)를 통해 미리 생성하거나 사전에 승인된 설정 이미지를 업로드하여 준비할 수 있습니다. 두 인물의 시각적 데이터를 분리된 캔버스 노드로 격리함으로써, 영상 생성 전에 프롬프트 시드와 안면 임베딩이 간섭받지 않도록 보호합니다.
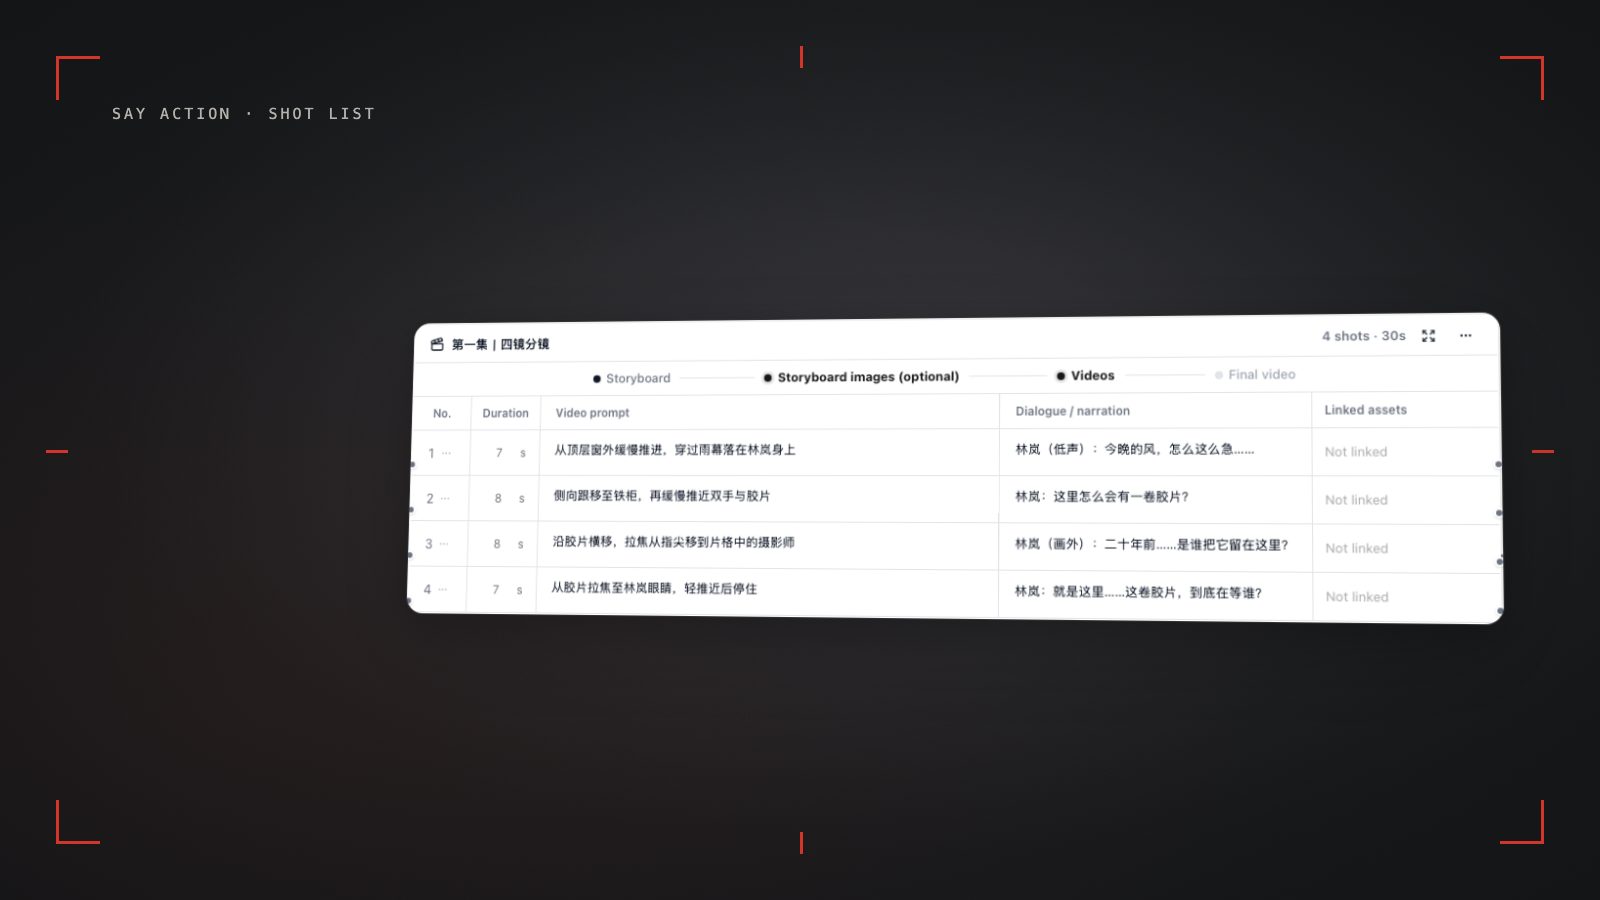
다음으로 각본 노드를 활용해 대본을 편집 가능한 콘티 테이블로 변환합니다. 앞서 수립한 4컷 분할 계획에 맞춰 대사와 리액션을 교차 행으로 분리합니다. 2행(컷 2: 인물 B를 향한 OTS)의 비디오 노드를 생성할 때는 오직 인물 B의 참조 노드에서만 연결선을 끌어와 비디오 입력 슬롯에 연결하고, Seedance 2.5 또는 MiniMax H3 모델을 선택합니다. 3행(컷 3: 인물 A를 향한 리버스 OTS)에서는 오직 인물 A의 참조 노드만 연결합니다. 컷별 생성 길이는 2~4초로 짧게 유지합니다. 짧은 모듈형 생성은 모델의 형태 변형을 방지하고 인물의 시선 방향과 미세 표정을 정밀하게 통제할 수 있게 돕습니다.
이러한 분리형 캔버스 노드 아키텍처는 반복 수정의 안전성과 비용 통제력을 획기적으로 높여줍니다. 만약 컷 3에서 인물의 머리 회전이 부자연스럽게 출력되더라도, 해당 노드의 모션 프롬프트만 수정하여 단독 재생성하면 되며 이미 승인된 컷 1, 2, 4에는 아무런 영향을 주지 않습니다. 크레딧 소모는 각 컷의 해상도와 길이에 따라 독립적으로 산정되며 작업 제출 전 예상 비용이 명확히 표시됩니다. 플랫폼 과금 및 환불 기준은 공식 제품 안내를 따릅니다: 모델 제공업체가 생성 실패를 명확히 확인하면 임시로 확보한 크레딧을 돌려드립니다. 연결이 끊기는 등 결과나 요금을 확인할 수 없을 때는 중복 정산을 막기 위해 확인 대기 상태로 둡니다. 사용 가능한 모델과 해상도, 생성 전 크레딧 예상 사용량은 제작 화면에서 확인하세요. 최종 차감 크레딧은 제출 전에 표시됩니다. 작업 공간 서비스 요금이며 모델 사용량은 포함하지 않습니다. API 비용은 별도입니다.
9:16 세로형 콘티의 180도 가상선 법칙: 시선 고정과 카메라 금기
기존 와이드스크린 영화에서도 두 인물을 잇는 가상의 선을 넘는 '180도 법칙 위반(축 점프)'은 시청자에게 심각한 공간적 혼란을 줍니다. 9:16 세로형 영상에서 이 위반은 더욱 치명적입니다. 스마트폰 화면은 좌우 폭이 좁아 인물 간의 물리적 간격이 시각적으로 밀착되어 보이기 때문에, 관객은 인물의 좌우 시선 방향에 전적으로 의존해 대화의 대상을 파악합니다. 만약 컷 2에서 인물 A가 화면 오른쪽을 바라보고 있는데, 역각도의 컷 3에서 인물 B마저 화면 오른쪽을 바라본다면 관객의 뇌는 두 사람이 마주 보고 대화하는 것이 아니라 같은 방향을 멍하니 바라보고 있다고 인식하게 됩니다.
생성된 컷들 간에 완벽한 시선 일치를 보장하려면 콘티 테이블의 모든 행에 엄격한 시선 프롬프트를 명시해야 합니다. 먼저 대화 주체들의 한쪽에 가상선을 설정하고 모든 카메라 셋업을 동일한 반원 내에 고정합니다. Say Action 콘티 테이블에서 프롬프트 작성 규칙을 표준화하십시오. 인물 A의 경우 eye level, facing screen-right, gaze directed slightly right of camera toward off-screen listener(눈높이, 화면 우측 응시, 카메라 우측 살짝 빗겨보기)로 설정하고, 인물 B의 경우 eye level, facing screen-left, gaze directed slightly left of camera toward off-screen speaker(눈높이, 화면 좌측 응시, 카메라 좌측 살짝 빗겨보기)로 고정합니다. 완전한 90도 측면이 아닌 '렌즈 살짝 옆'을 응시하게 해야 얼굴 연기를 정면성 있게 전달하면서도 정확한 시선 교차를 형성할 수 있습니다.
이에 못지않게 중요한 것이 대화 씬에서의 카메라 무빙 절제입니다. 액션 씬에서는 격렬한 트래킹이나 크레인 무빙이 시각적 쾌감을 주지만, 대화 씬에서 통제되지 않은 가상 카메라의 움직임은 공간적 기준점을 산산조각 냅니다. OTS 샷 프롬프트에 "인물 주위를 회전하는 궤도 샷(orbit)"이나 "빠른 패닝"을 작성하는 것은 피해야 합니다. 확산 모델이 궤도 회전을 연산하는 도중 화면 좌우 좌표를 뒤집어버리는 치명적 오류가 빈번하게 발생하기 때문입니다. 완벽히 고정된 삼각대 샷(locked-off tripod shot)이나 감정적 긴장감을 고조시키는 극미세 슬로우 돌리인(slow subtle dolly-in, 0.5x speed)에 집중하여 축을 완벽히 수호하십시오.
클립 내보내기와 외부 편집기 오디오 싱크: 자연스러운 대화 호흡 완성
Say Action 캔버스에서 대화 컷 생성이 완료되면 체계적인 에셋 관리를 통해 후반 편집 단계로 인계합니다. Say Action의 로컬 우선 저장 기능을 활용하여 생성된 MP4 비디오 클립들을 로컬 드라이브의 구조화된 프로젝트 폴더에 직접 저장합니다. 파일 이름은 Scene03_Shot01_Master, Scene03_Shot02_OTS_CharB, Scene03_Shot03_Reverse_CharA, Scene03_Shot04_Reaction_CharA와 같이 씬 번호와 컷 번호를 엄격히 반영하여 명명합니다. 체계적인 네이밍과 로컬 파일 관리는 CapCut, Premiere, DaVinci Resolve 등의 비선형 편집기(NLE)로 타임라인을 구성할 때 미디어 링크 유실이나 혼선을 원천적으로 방지합니다.
타임라인에서는 고전적인 J컷 및 L컷 오디오 스플릿 편집 기법을 적극 활용하여 대화를 조립합니다. 화면 전환과 음성 시작을 칼같이 일치시키는 하드 컷 대신, 인물 A의 얼굴이 등장하기 0.5초 전에 목소리를 먼저 흘려보내거나, 인물 A의 대사가 끝나는 순간 화면을 인물 B의 리액션 표정으로 먼저 넘겨 음성을 이어받습니다. 숏폼 드라마에서는 1.5~3.0초 주기로 컷을 전환하는 빠른 템포가 시청 지속 시간을 극대화합니다. 만약 AI 영상 끝부분에서 입모양에 미세한 어색함이 발생하더라도, 오디오 트랙은 온전히 유지한 채 비디오를 리액션 컷으로 빠르게 전환함으로써 어떠한 흠집도 남기지 않고 매끄럽게 연결할 수 있습니다.
마지막으로 시각적 연기 생성과 최종 오디오 동기화 작업을 명확히 분리하여 운영합니다. Say Action은 각본 분해, 콘티 관리, 키프레임 생성, 다중 모델 비디오 렌더링에 집중하며, 최종 캐릭터 목소리는 후반 편집 단계에서 보이스 트랙 및 외부 립싱크 도구를 결합하여 완성합니다. 편집 과정에서 특정 컷의 감정 농도가 부족하거나 시선 방향이 어긋난 것으로 확인되더라도 씬 전체를 새로 만들 필요가 전혀 없습니다. Say Action 캔버스의 해당 노드로 돌아가 모션 프롬프트를 미세 조정하고 해당 클립만 단독 재생성하여 기존 타임라인에 교체 삽입하면 즉시 해결됩니다.
내 API 채널과 외부 API 중계 서비스 연결하기
모델 채널 설정에 Base URL과 API 키를 입력한 뒤 제공업체 문서에 따라 API 방식, 모델 ID와 필요한 헤더를 설정하세요. 생성 전에 원하는 이미지·영상 생성 방식을 지원하는지 확인하세요. 경로, 해상도와 시작·끝 프레임 입력은 연결한 채널에 따라 다릅니다. 미지원 채널의 연동 신청이 호환성 보장을 뜻하지는 않습니다.
BYOK에서는 API 주소, 모델 키와 사용자 지정 헤더를 설정할 수 있습니다. OneAPI나 NewAPI 같은 중계 서비스를 쓸 때는 실제 API에 맞는 OpenAI, Gemini 또는 Claude 방식을 선택하고 모델 ID와 이미지·영상 API 지원 여부를 확인하세요. 모든 중계 서비스나 비공개 규격이 자동으로 호환되는 것은 아닙니다. BYOK 모델 호출에는 플랫폼 추가 마진이나 생성 크레딧 차감이 없지만, 작업 공간과 모델 제공업체 이용료는 별도로 청구됩니다.
신뢰하는 제공업체만 연결하고 운영 환경에서는 HTTPS를 사용하세요. 요청은 로그인 인증된 백엔드를 거쳐 전달되며 필요한 프롬프트, 참고 자료와 인증 정보가 요청에 사용됩니다. API 키, 비밀번호나 비밀 정보가 든 헤더를 공개 캔버스, 스크린샷 또는 지원 신청에 포함하지 마세요.
자주 묻는 질문
15초 길이의 단일 클립에서 두 사람이 계속 대화하도록 생성할 수 있나요?
권장하지 않습니다. 하나의 긴 영상 클립에서 상호작용하는 두 인물을 동시에 렌더링하면 심각한 얼굴 붕괴와 특성 뒤섞임이 발생합니다. 대화를 2~4초 단위의 단독 쇼트-리버스-쇼트 컷으로 분할해 각각 생성한 뒤 편집기에서 이어붙이는 것이 표준 실무입니다.
OTS 샷에서 전경의 아웃포커싱된 어깨가 변형되거나 왜곡되는 것을 어떻게 막나요?
프롬프트에서 전경 인물을 "구석의 어둡고 흐린 실루엣 어깨(blurred dark foreground shoulder out of focus in corner)"와 같이 순수한 광학적 실루엣으로 정의하십시오. 전경 인물을 구체적인 신체로 묘사하지 않아야 모델이 불필요한 얼굴이나 팔다리를 합성하려는 시도를 차단할 수 있습니다.
컷 전환 시 AI가 인물의 시선 방향을 반대로 뒤집어버리면 어떻게 해야 하나요?
콘티 테이블의 프롬프트 열에 시선 방향을 명확히 고정하여 작성하십시오(예: "eye level, facing screen-right toward conversational partner"). 특정 컷의 시선이 어긋났다면 씬 전체를 건드리지 않고 캔버스에서 해당 단일 비디오 노드만 단독 재생성하면 됩니다.
Say Action에서 캐릭터 대사에 맞춰 자동으로 정밀한 립싱크를 맞춰주나요?
Say Action은 각본 분해, 콘티 관리, 키프레임 생성, 다중 모델 비디오 렌더링에 집중합니다. 최종 캐릭터 음성과 립싱크는 생성된 비디오 클립을 외부 편집기(CapCut, Premiere 등)로 내보내 오디오 트랙과 결합하거나 전문 립싱크 툴을 연계하여 완성합니다.
OneAPI, NewAPI와 사용자 지정 헤더를 연결할 수 있나요?
BYOK에서는 API 주소, 모델 키와 사용자 지정 헤더를 설정할 수 있습니다. OneAPI나 NewAPI 같은 중계 서비스를 쓸 때는 실제 API에 맞는 OpenAI, Gemini 또는 Claude 방식을 선택하고 모델 ID와 이미지·영상 API 지원 여부를 확인하세요. 모든 중계 서비스나 비공개 규격이 자동으로 호환되는 것은 아닙니다. BYOK 모델 호출에는 플랫폼 추가 마진이나 생성 크레딧 차감이 없지만, 작업 공간과 모델 제공업체 이용료는 별도로 청구됩니다.